¿Cuánta RAM necesita tu portátil para usar IA en local?
Un modelo pequeño de IA que funciona en tu propio portátil ya puede leer textos, analizar imágenes y responder a tus preguntas sin necesidad de una cuenta en la nube. Esta noche, descarga qwen3.5:4b-q4_K_M (Qwen), un archivo de 3,4 GB: el modelo puede hacer exactamente eso en un portátil corriente con 16 GB de RAM. Es un LLM, o modelo de lenguaje de gran tamaño. Descárgalo con Ollama, hazle una pregunta con un contexto de 4K y ya estarás ejecutando un modelo de IA real en local con el hardware que ya tienes. Lee texto e imágenes, y aquí hablamos de inferencia, no de entrenamiento: nadie le está enseñando nada nuevo al modelo, solo responde.
La vaga pegatina de "AI PC" en la caja de un portátil no es una especificación. Lo que sí importa es la RAM, la memoria que puede usar tu GPU, el almacenamiento y una compatibilidad real con el software. 16 GB de memoria son un punto de partida de verdad para modelos pequeños de IA, no un mínimo insuficiente ni una promesa de todo lo que anuncia una ficha técnica. Más memoria te da más contexto y más margen para multitarea. Con 16 GB ya puedes empezar.
Qué usa realmente la RAM de tu portátil al ejecutar IA
El tamaño de descarga de un modelo y la RAM que ocupa mientras se ejecuta son dos cifras distintas, y confundirlas es el error más habitual al comprar un portátil para IA. Esos 3,4 GB que descargas de qwen3.5:4b-q4_K_M son el archivo en disco. Cargarlo requiere memoria de verdad. También la necesita la ventana de contexto, es decir, la conversación en curso que el modelo mantiene presente mientras responde, llamada caché KV. A eso se suma el propio motor, además de lo que ya estén consumiendo tu sistema operativo y otras aplicaciones.
Ollama carga por defecto un contexto de 4 096 tokens, y puedes ampliarlo. Si ejecutas varias solicitudes a la vez, la memoria necesaria para el contexto se multiplica, más o menos, por el número de peticiones en paralelo. La ficha técnica de un modelo puede anunciar una ventana de contexto de 128K o 256K tokens: tómalo como el techo del modelo, no como una promesa de que tu portátil con 16 GB pueda permitirse usarlo entero al mismo tiempo.
RAM, VRAM y memoria unificada no salen del mismo sitio
Los chips Apple Silicon usan memoria unificada: la CPU y la GPU recurren al mismo bloque de 16, 24 o 32 GB, así que no hay una memoria gráfica aparte que pueda quedarse corta. En un portátil habitual con Windows o Linux y una GPU NVIDIA dedicada, funciona de otra manera. La RAM del sistema y la VRAM de la GPU son dos bloques distintos, y 16 GB de RAM del sistema más una GPU de 8 GB no forman un único bloque de 24 GB que el modelo pueda usar libremente.
Cuando un modelo no cabe por completo en la GPU, una parte pasa a ejecutarse en la CPU, una descarga parcial que puede hacer que un modelo técnicamente compatible vaya bastante más lento. Si ejecutas , verás exactamente ese reparto entre CPU y GPU para lo que tengas cargado en ese momento.
La capacidad es solo la mitad de la historia. La velocidad a la que se mueve esa memoria importa tanto como la cantidad: Apple indica 153 GB/s de ancho de banda de memoria en el MacBook Air M5, y ese ancho de banda, no solo la cifra total, explica por qué la memoria unificada responde con soltura y no se queda justa sobre el papel.
Cuantización: cómo un modelo de IA de 9B cabe en tu RAM
La cuantización es lo que hace posible esa descarga de 3,4 GB: al guardar los pesos del modelo con una precisión numérica menor, el archivo se reduce, y el propio modelo 9B de Qwen3.5 deja muy claro ese margen. El mismo modelo de 9B ocupa 6,6 GB como Q4_K_M, 11 GB como Q8_0 y 19 GB con precisión BF16 completa. Mismo modelo, mismo número de parámetros, tres tamaños de descarga muy distintos y, una vez más, hablamos del tamaño del archivo, no de la RAM que necesita al ejecutarse.
Una precisión más baja suele implicar cierta pérdida de calidad, pero cuánto se nota depende de la tarea, no de un porcentaje fijo. Y hay un detalle práctico que conviene saber antes de elegir Qwen como primer modelo: algunas personas comentan que su paso de "thinking" añade una espera perceptible antes de que aparezca la respuesta, en comparación con modelos que responden de forma más directa. Lo mejor es probar ambos estilos con tus propias tareas, en lugar de dar por hecho que uno es simplemente mejor.
¿Ya tienes un MacBook con 16 GB? Prueba esto antes de comprar nada
Si ya tienes un MacBook con 16 GB, empieza con un modelo de 2-4B en precisión Q4 y un contexto de 4K antes de plantearte cualquier compra. Puede que también cargue un modelo 9B Q4, o algo como Gemma 4 12B QAT. Que lo haga o no depende de cuántas aplicaciones tengas abiertas, del contexto que uses y de lo cargada que vaya ya la máquina, así que merece la pena probarlo, pero no darlo por seguro.
¿Quieres comprar un equipo nuevo justo para esto? El MacBook Air de 13 pulgadas con chip M5 viene de serie con 16 GB de memoria unificada y puede configurarse hasta 32 GB. Y antes de que te tiente una pantalla más grande como mejora: el Air M5 de 15 pulgadas parte de las mismas opciones de memoria de 16, 24 y 32 GB y del mismo ancho de banda de 153 GB/s que el de 13 pulgadas. Elige el tamaño de pantalla por comodidad, no porque creas que te dará más margen para IA. No lo hará.
¿Ya tienes un portátil Windows o Linux con 16 GB? Empieza por aquí
Un portátil con Windows o Linux y 16 GB, incluso sin GPU dedicada, todavía puede ejecutar un modelo pequeño. Ollama funciona de forma nativa en Windows, así que descarga un modelo Q4 de 2-4B y pruébalo en la CPU o en los gráficos integrados antes de gastar dinero. Eso sí, aquí el resultado puede variar más que en Apple Silicon: no hay una cifra fija de tokens por segundo que sirva para todas las máquinas, porque nadie ha medido todas las configuraciones.
El Lenovo ThinkPad T14 G2 y el HP EliteBook x360 1040 G7 se sitúan justo en este nivel, con 16 GB de RAM y gráficos integrados. Hay algo que conviene comprobar primero, sobre todo en un reacondicionado con algunos años como estos dos: LM Studio exige compatibilidad con AVX2 en Windows x64, un conjunto de instrucciones que no está presente en todas las CPU antiguas. Confirma que tu procesador concreto lo admite antes de dar por hecho que cualquier portátil de esta gama podrá ejecutar la herramienta que elijas.
GPU para portátil, nombres que engañan: por qué «RTX 5070 Ti» no es una sola cifra
Las GPU para portátil de NVIDIA comparten nombre con las tarjetas de sobremesa, y ese nombre dice menos de lo que parece. La RTX 5060 Laptop GPU lleva 8 GB de memoria GDDR7 y un rango de potencia publicado de 45 a 100 vatios. La RTX 5070 Ti Laptop GPU lleva 12 GB de GDDR7 y de 60 a 115 vatios. Un resultado en internet de una RTX 5070 Ti de sobremesa no equivale al de una RTX 5070 Ti Laptop GPU, por mucho que el nombre invite a pensarlo.
Y hay una segunda trampa escondida en ese mismo nombre. Dos portátiles pueden montar una «RTX 5070 Ti Laptop GPU» y aun así rendir distinto bajo carga sostenida: un chasis fino y ligero y otro más grueso y pesado gestionan el calor de forma diferente, y llevar la misma GPU no garantiza la misma velocidad real cuando los ventiladores ya llevan un rato funcionando. Comprueba siempre la cifra exacta de VRAM y la configuración de potencia del propio portátil, no solo la familia de la GPU.
Si compras un Mac nuevo: el nivel cómodo de memoria unificada
Si vas a comprar un portátil pensado específicamente para usar IA local con frecuencia, 24 o 32 GB de memoria unificada es el nivel más cómodo dentro de Apple: deja margen real para un modelo mayor, un contexto más largo o, sencillamente, para seguir trabajando con otras aplicaciones abiertas. Ve a por 32 GB si crees que lo vas a usar a menudo y el presupuesto te lo permite.
El MacBook Pro de 13 pulgadas con chip M2 es un ejemplo reacondicionado real que ya se sitúa por encima del escalón de entrada de 16 GB: su CPU de 8 núcleos y su GPU de 10 núcleos pueden combinarse con hasta 24 GB de memoria unificada. Es una generación de chip anterior al Air con M5, así que aquí lo esperable es ese tope de 24 GB, no las opciones independientes de 24 y 32 GB del Air M5.
Si vas a comprar un portátil nuevo con Windows o Linux, busca una GPU dedicada.
Si vas a comprar un equipo nuevo con la IA local como prioridad, busca 32 GB de RAM del sistema junto con una GPU NVIDIA para portátil dedicada con al menos 8 GB de VRAM propia, y 12 GB si te encaja asumir un portátil algo más pesado o más caro. 8 GB pueden ser un objetivo razonable para modelos de 4-7B en precisión Q4 y con un contexto moderado, pero no lo tomes como margen automático: incluso la descarga de 6,6 GB de un modelo 9B Q4 puede necesitar más de 8 GB para funcionar con comodidad, y 12 GB simplemente facilitan mucho más las pruebas en ese tamaño.
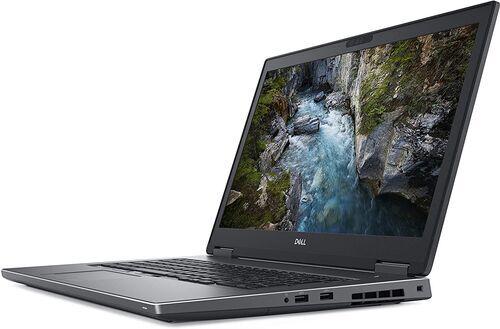
El Dell Precision 7730 es un ejemplo reacondicionado real de esa idea de base, aunque no monte exactamente los chips nuevos mencionados arriba: sus 32 GB de memoria del sistema se combinan con una NVIDIA Quadro P3200 dedicada con 6 GB de VRAM propia, una generación y una gama de GPU distintas de las actuales RTX 5060 y 5070 Ti Laptop GPU de NVIDIA, pero con el mismo principio de bloques separados.
Una alternativa a tener en cuenta: los chips para portátil de AMD con mucha memoria
El procesador Ryzen AI Max+ 395 de AMD admite hasta 128 GB de memoria LPDDR5x del sistema, según cómo esté configurado el portátil final. Es una arquitectura de memoria distinta que conviene conocer, y tiene un matiz importante: la lista de compatibilidad de ROCm para Linux de Ollama menciona este chip, mientras que su lista actual de ROCm para Windows no lo incluye.
Eso invita a comprobar la memoria instalada exacta, el sistema operativo, el backend de la GPU, el controlador y el comportamiento de Ollama en un portátil concreto antes de recomendarlo, no a descartar el chip sin más. Piensa en un portátil AMD con mucha memoria como una arquitectura alternativa interesante que merece una revisión cuidadosa, no como la compra por defecto para quien empieza a ejecutar IA en local.
La base de software: Ollama y LM Studio, explicados de forma clara
Ollama es la forma más sencilla de poner un modelo a funcionar en tu propia máquina: descargas un modelo, lo ejecutas y ya tienes un servidor local respondiendo solicitudes, sin necesidad de una cuenta en la nube para un modelo descargado. Es la herramienta que hay detrás de todos los ejemplos de aquí.
LM Studio ofrece una alternativa gráfica con su propio buscador de modelos y ventana de chat. También publica sus mínimos: al menos 16 GB de RAM en Mac o Windows, compatibilidad con AVX2 obligatoria en Windows x64 y 4 GB de VRAM dedicada recomendados en Windows. Configurar bien cualquiera de los dos daría para una guía aparte.
Y una advertencia antes de fiarte de una sola cifra de velocidad vista en internet: la herramienta oficial llama-bench separa la velocidad de procesamiento del prompt de la velocidad de generación y muestra la variación entre varias pruebas repetidas, no un único dato. Un mensaje de foro que cita una sola cifra de tokens por segundo rara vez aclara cuál de las dos estaba midiendo ni cuántas veces se repitió la prueba.
Qué revisar antes de comprar o mejorar un portátil preparado para IA
Antes de comprar o mejorar un portátil específicamente para IA local, revisa los detalles concretos y no el marketing.
Modelo exacto de GPU y VRAM. No solo la familia de la GPU, sino la variante concreta del portátil y su propia cifra de memoria, porque un mismo nombre puede esconder cantidades distintas de VRAM.
RAM soldada o ampliable. Algunos portátiles permiten añadir memoria más adelante; muchos modelos finos y ligeros actuales no. Conviene saber cuál estás comprando.
Espacio libre en el SSD. Las descargas de modelos van desde menos de 1 GB hasta bastante más de 10, y una colección creciente ocupa espacio rápido junto a tus demás archivos.
Comportamiento térmico bajo carga sostenida. No es lo mismo un modelo respondiendo a una sola pregunta que un portátil gestionando varias solicitudes seguidas; el ruido de los ventiladores y la pérdida de rendimiento tras varios prompts dicen más que una demo rápida.
Compatibilidad de sistema operativo y controladores. Confirma que la combinación exacta de backend de GPU y sistema operativo tiene soporte en Ollama o LM Studio antes de darlo por hecho.
La cifra de TOPS de la NPU en la caja no garantiza rendimiento. Es una cifra de marketing, no un resultado medido con el motor que vas a usar. Una etiqueta vaga de "AI PC" no sustituye ninguna de las comprobaciones anteriores.
Cinco portátiles reacondicionados que ya encajan en estos niveles
Preguntas frecuentes sobre usar IA en un portátil
¿Necesito una GPU dedicada para usar IA en local?
No. Un modelo pequeño puede funcionar en la CPU o en los gráficos integrados de muchos portátiles con 16 GB, solo que con más variación de velocidad que en un portátil con GPU dedicada. Empieza con un modelo de 2-4B antes de asumir que necesitas gráficos dedicados sí o sí.
¿Sirven 8 GB de RAM?
No con comodidad para los modelos tratados aquí. 16 GB es el punto de partida realista cuando tienes en cuenta que el modelo, su ventana de contexto, el motor y el sistema operativo comparten la misma memoria.
¿Ejecutar un modelo en local es lo mismo que entrenarlo?
No. Todo lo anterior es inferencia: hacer preguntas a un modelo ya entrenado. El entrenamiento crea un modelo desde cero y exige muchísimo más hardware que cualquiera de los portátiles mencionados aquí.
¿Más RAM garantiza respuestas más rápidas?
No. Más memoria te da margen para modelos mayores, contextos más largos y más aplicaciones abiertas, pero la velocidad real depende del ancho de banda de memoria, del backend de la GPU y del modelo concreto, no solo del tamaño de la memoria.
¿Mis datos son privados cuando un modelo se ejecuta en local?
Sí, en el sentido de que tus prompts se quedan en tu máquina en lugar de enviarse a un proveedor en la nube. Ollama se vincula por defecto a tu propio portátil y no envía solicitudes a ningún otro sitio salvo que configures expresamente acceso en la nube.
Pruébalo esta noche y compra con confianza
¿Ya tienes un portátil con 16 GB? Instala Ollama hoy y ejecuta un modelo pequeño antes de gastar un euro en algo nuevo. ¿Vas a comprar uno específicamente para esto? Usa la lista de comprobación anterior y los cinco portátiles reacondicionados que acabamos de ver como punto de partida para comparar, en lugar de fiarte de una ficha de marketing.
Todos los portátiles de refurbed se prueban y clasifican antes de ponerse a la venta, así que la RAM y la configuración que compras son exactamente las que recibes. La siguiente guía de esta serie explica cómo conectar tu primera app al modelo que acabas de probar.


¡Suscríbete a nuestro boletín por primera vez y ahorra 15 €!
No vuelvas a perderte ninguna oferta.
Encontrarás información sobre el uso de datos personales en nuestra Política de privacidad.
Descárgate la app de refurbed
Para iOS y Android


Confirmar registro
Ya casi está: te hemos enviado un correo electrónico de confirmación
- © Refurbed Marketplace GmbH
- Accesibilidad
- Términos y Condiciones
- Política de privacidad
- Aviso legal
- Avisos legales
- European Data Act
- Cookie Policy