Los mejores modelos pequeños de IA en local: un kit para tu portátil
En un portátil corriente con 16 GB de memoria, el modelo qwen3.5:4b-q4_K_M ya responde preguntas sin conexión a internet. Es el mismo de la segunda entrega de esta serie y cumple bien como asistente general. Pero no conviene pedirle además que busque en tus archivos o resuelva tareas de programación. Si esperas que una sola descarga lo haga todo, acabarás con un modelo sobrecargado en lugar de tres pequeños, cada uno con su cometido.
Tener el control de tu instalación de IA en local supone elegir el modelo, el motor y la licencia, además de decidir qué datos se quedan en cada sitio. Si aún no has comprobado la RAM o la VRAM de tu portátil, consulta primero cuánta RAM necesita tu portátil para ejecutar IA en local. Si todavía no has instalado Ollama, sigue la guía para configurar tu primer proveedor de IA local. Partimos de que ya has hecho ambas cosas. Ahora toca elegir modelos y comprobar si dan la talla.
Los mejores modelos pequeños de IA para ejecutar en local según la tarea
Un kit útil de IA local cubre tres tareas distintas, sin encargarle las tres al mismo modelo.
Un asistente general para conversar a diario, redactar y resolver dudas rápidas: qwen3.5:4b-q4_K_M. Es la misma etiqueta que en la segunda parte y su descarga ocupa 3,4 GB.
Un especialista compacto para tareas más concretas, como generar resultados estructurados o resolver un problema de razonamiento con restricciones: granite4.2:3b. La descarga ocupa 2,2 GB. El modelo tiene licencia Apache 2.0 y se publicó en agosto de 2026. En el apartado 6 encontrarás otras opciones para programación, matemáticas, análisis de imágenes y traducción. Así podrás sustituirlo por el especialista que necesites.
Un modelo de embeddings para buscar en tus documentos: embeddinggemma:300m. Su descarga ocupa 622 MB. No sirve para chatear: convierte textos en vectores que consulta una aplicación de búsqueda. En el apartado 8 explicamos el proceso con más detalle.
Las tres descargas suman unos 6,2 GB en disco, pero esa cifra no equivale a una única reserva de memoria. Si mantienes los tres modelos cargados a la vez, aún pueden superar la memoria libre de tu portátil. Lo más práctico es cargar solo el que necesites para cada tarea, probarlo con un caso real y eliminar los que no se ganen su sitio.
Qué cambia al cuantizar un modelo
Basta comparar versiones de una misma familia para ver el efecto de la cuantización. En el catálogo de Ollama, qwen3.5:9b-q4_K_M tiene una descarga de 6,6 GB; qwen3.5:9b-q8_0, de 11 GB; y qwen3.5:9b-bf16, de 19 GB. Los pesos son los mismos; cambian la precisión y el tamaño de la descarga.
Las cifras del catálogo corresponden a las descargas; no permiten saber con certeza cuánta memoria ocupará cada modelo una vez cargado. Con menos precisión, el archivo ocupa menos espacio y, a menudo, el modelo necesita menos memoria al cargarlo. Pero la posible pérdida de calidad en las respuestas depende del modelo, del cuantizador y de la tarea: no des por hecho que la calidad será la misma ni que ahorrar espacio sale gratis.
Los pesos no son lo único que ocupa memoria al cargar un modelo. También hay que dejar margen para la ventana de contexto, su caché de claves y valores y los demás programas que tengas abiertos. Liberar memoria mediante la cuantización no garantiza que quepa un modelo mayor, pero sí hace más razonable intentarlo que empezar por el archivo de precisión completa.
Dos etiquetas que pueden llevarte a descargar lo que no querías
Hay dos etiquetas de este catálogo que se prestan a confusión. En ambos casos, puedes acabar con una descarga distinta de la que buscabas.
Primera trampa. En su ficha, Google atribuye a Gemma 4 E2B 2 300 millones de parámetros de lenguaje «efectivos». La cifra hace pensar en una descarga pequeña, pero en Ollama ocupa 7,2 GB: casi tanto como la versión Q4 de gemma4:12b, de 7,6 GB. Para saber qué cabe en tu portátil, consulta el tamaño de la descarga, no la cifra de parámetros.
Segunda trampa. Si la etiqueta no especifica la versión concreta, puedes descargar otro modelo sin darte cuenta. Al descargar granite4.2 a secas, obtendrás el modelo 8B de 5,3 GB, no la versión 3B de 2,2 GB del apartado 2. Si haces lo mismo con qwen3-embedding, descargarás el modelo 8B de 4,7 GB, no la versión 0,6B de 639 MB que usaremos en el apartado 8.
En ambos casos, descarga siempre la etiqueta completa con la versión concreta, nunca solo el nombre de la familia. Comprueba cuánto ocupa la descarga antes de dar por hecho que has elegido el modelo que querías probar.
La ventana de contexto predeterminada de Ollama
Cuando el catálogo indica un máximo de 128K o 256K tokens, se refiere a lo que el modelo puede admitir en principio. No garantiza que un portátil con 16 GB tenga memoria suficiente para llegar a ese límite.
Por defecto, Ollama establece un contexto de 4 096 tokens. Puedes ampliarlo, pero tanto un contexto más largo como un mayor número de peticiones simultáneas aumentan el consumo de memoria. El ajuste num_ctx: 4096 de la segunda parte de esta serie corresponde a ese mismo valor predeterminado y prudente; no es una cifra redonda elegida al azar.
Cuando pruebes un modelo nuevo, empieza con un contexto de entre 4 000 y 8 000 tokens y una sola sesión activa. Vigila la memoria del sistema y amplía el contexto solo cuando compruebes que el consumo se mantiene estable, no porque la ficha del catálogo diga que técnicamente puedes hacerlo.
Cómo elegir el mejor modelo pequeño de IA para tu tarea
No hay un especialista que sea el mejor para todo: lo que cuenta es tu tarea. Estos son algunos modelos pequeños que merece la pena probar con ella.
Programación: qwen2.5-coder:3b (1,9 GB) o el modelo mayor qwen2.5-coder:7b (4,7 GB), ambos con licencia Apache 2.0.
Matemáticas o lógica con restricciones: phi4-mini:3.8b (2,5 GB), de Microsoft.
Preguntas sobre imágenes y capturas de pantalla: gemma4:e2b (7,2 GB) o gemma4:12b Q4 (7,6 GB). Ambos tienen licencia Apache 2.0 y, según sus fichas, admiten texto e imágenes como entrada.
Redacción multilingüe o traducción: aya-expanse:8b (5,1 GB), creado para 23 idiomas.
La licencia de Aya Expanse 8B no debe quedar relegada a una nota al pie: es CC-BY-NC-4.0, tiene condiciones adicionales y se limita al uso no comercial. No lo trates como una opción por defecto sin restricciones junto a los modelos anteriores con licencia Apache. Si ninguna de estas cuatro tareas coincide con la tuya, granite4.2:3b, del apartado 2, sigue siendo nuestra elección general para razonamiento.
Pruébalos con tu propia tarea antes de decidirte. Un especialista, como el asistente general, se gana su sitio por ayudarte con lo que le pides, no por encabezar una clasificación hecha por otros.
Antes de confiar en un modelo: cinco pruebas que puedes repetir
Cinco pruebas breves te dirán más sobre un modelo que cualquier ficha del catálogo. Hazlas todas con cada candidato y utiliza tus propios materiales.
1. Un resumen respaldado por el texto. Dale una nota de 250 palabras y pídele tres acciones concretas, cada una acompañada de la frase en la que se basa. Señala cualquier afirmación que no esté respaldada por la nota.
2. Extracción estructurada. Inventa cinco citas para una agenda, con nombres y fechas; pídele un JSON que contenga exactamente los campos que especifiques y comprueba los cinco resultados con lo que escribiste.
3. Corrección de código. Dale una función breve que falle y una prueba. Anota si la prueba pasa tras la corrección y usa el mismo repositorio y el mismo contexto con todos los modelos que compares.
4. Una traducción entre dos idiomas. Pide a alguien que lea con soltura en ambos idiomas que compruebe si la traducción de un párrafo verosímil conserva nombres, números y matices. No evalúes la calidad multilingüe con una petición redactada solo en inglés.
5. Una pregunta sobre una imagen, solo para modelos que admitan imágenes. Muéstrales un gráfico o una captura de pantalla y hazles una pregunta cuya respuesta puedas comprobar. Asegúrate de enviar la imagen, no solo el nombre del archivo.
En cada prueba, anota si la respuesta coincide con la que sabes que es correcta, si el modelo siguió tus instrucciones, si inventó algo, cuánto tardó en aparecer el primer fragmento de respuesta, el tiempo total, cuántos tokens utilizó y si se ejecutó en la CPU o en la GPU. Valora por separado la utilidad y la velocidad: un modelo que razona antes de responder puede dedicar tiempo a procesar tokens que nunca verás.
Una pequeña ampliación: búsqueda en documentos con RAG local
El modelo de embeddings del apartado 2 se limita a convertir textos en vectores que puede consultar una aplicación de búsqueda. Por sí solo no responde preguntas.
El orden importa: primero, tus archivos se dividen en fragmentos y el modelo de embeddings convierte cada uno en un vector. Una base vectorial local guarda esos vectores. Después, tu consulta también se convierte en un vector y se recuperan los fragmentos más próximos. Solo entonces un modelo de chat responde a partir de esos fragmentos y los cita.
El modelo de chat nunca se entrenó con tus documentos. Solo ve lo que le entrega la búsqueda cuando haces la consulta.
Una prueba sencilla permite comprobarlo sin apenas preparación: indexa cinco notas que ya tengas. Haz una pregunta cuya respuesta esté en una de ellas y otra que no tenga respuesta en ninguna. Si el sistema funciona, recuperará y citará el pasaje adecuado para la primera; para la segunda, reconocerá que no tiene información para responder, en vez de inventársela. Evalúa por separado la recuperación y la respuesta final.
Antes de descargar el modelo de embeddings, comprueba su etiqueta exacta: embeddinggemma:300m o qwen3-embedding:0.6b. Como vimos en el apartado 4, el nombre de la familia por sí solo puede llevarte a descargar otro modelo.
Menos parámetros activos no significan menos espacio de almacenamiento
Un modelo con una etiqueta como «26B A4B» solo activa una parte de sus parámetros al generar cada token. Aun así, tiene que guardar en algún sitio los pesos de sus 26B parámetros o cargarlos sobre la marcha. Activar menos parámetros no implica ni un archivo más pequeño ni un menor consumo de memoria.
Este kit no incluye cifras de rendimiento obtenidas en nuevas pruebas. Si una cifra procede de otra fuente, como los cerca de 18,5 tokens por segundo que una persona dijo haber obtenido al ejecutar un modelo de mezcla de expertos de 26B con una CPU antigua y una GPU de 6 GB en una configuración poco habitual, tómala por lo que es: el resultado de ese equipo y esa configuración, no una expectativa general para todos los modelos con esa etiqueta.
Los portátiles con los que probamos este kit
Probamos este kit en dos portátiles reales y actuales, los mismos que usamos en la segunda entrega de la serie: un equipo básico con Apple Silicon y una estación de trabajo con Windows y memoria gráfica dedicada. Los dos están reacondicionados: profesionales los han probado, limpiado y puesto a punto. Cuentan con una garantía de 12 meses en refurbed y tienen capacidad de sobra para este kit, con un modelo cargado cada vez.
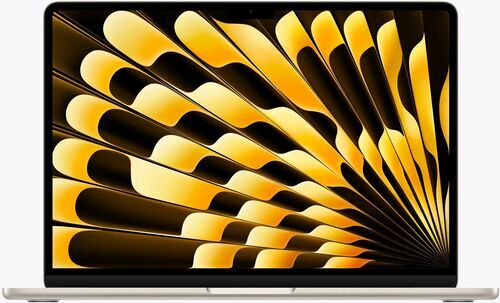
El MacBook Air de 13 pulgadas (2026) con chip M5 viene de serie con 16 GB de memoria unificada y puede configurarse con hasta 32 GB. El Dell Precision 7730 cuenta con 32 GB de memoria del sistema y 6 GB de VRAM dedicada de NVIDIA. Son dos memorias independientes: no se pueden sumar como si fueran una sola.
No se trata de venderte ninguno de los dos. Los tomamos como referencia para esta guía: así puedes comparar tu portátil con equipos concretos, no con una ficha técnica publicitaria.

Licencias y cómo mantener al día tu selección de modelos
La licencia se aplica a cada modelo concreto, no a toda la familia. Qwen3.5 4B, Qwen2.5-Coder, Granite 4.2 3B y Gemma 4 E2B tienen licencia Apache 2.0. Aya Expanse 8B tiene licencia CC-BY-NC-4.0, con condiciones adicionales y limitada al uso no comercial, como ya vimos en el apartado 6. Poder descargar los pesos de un modelo, contar con permiso de los titulares de los derechos de autor para usarlos y «poseer» el modelo que hay detrás son tres cosas distintas. Consulta la ficha vigente del modelo exacto que descargues; no te guíes solo por el nombre de la familia.
Mantener un kit pequeño exige revisar qué modelos conservas; no basta con elegir bien una vez. Con ollama rm eliminas un modelo descargado que no se ha ganado su sitio; por ejemplo, ollama rm aya-expanse:8b si ya sabes que no lo usarás. Con ollama ls ves qué modelos tienes guardados en el disco; con ollama ps, cuáles están cargados. Los catálogos cambian, así que revisa tu selección en lugar de dar por buena una decisión de hace meses.
Incluso los modelos pequeños pueden inventarse un pasaje, pasar por alto un matiz en otro idioma o generar código que parece correcto, pero no supera la prueba. Considera cada recomendación de esta guía un punto de partida para tus propias pruebas, nunca un sustituto de una revisión experta cuando el resultado importe.
Los mejores modelos pequeños de IA en local: preguntas frecuentes
¿Puedo ejecutar los tres modelos del kit a la vez? En un portátil de 16 GB, probablemente no puedas hacerlo con comodidad. Carga solo el modelo que necesites para la tarea que tengas entre manos y cambia a otro al terminar, en lugar de mantener cargados a la vez el asistente general, el especialista y el modelo de embeddings.
¿Necesito una GPU para el modelo de embeddings? No. embeddinggemma:300m es lo bastante pequeño para probarlo solo con la CPU. Aun así, mide cuánto tarda: no des por hecho que la prueba será instantánea.
¿Un modelo más grande siempre dará mejores respuestas? No. Según la tarea, puede responder mejor un modelo 4B o uno 9B. Por eso, en el apartado 7 proponemos cinco pruebas en lugar de basarnos en una única cifra de una clasificación.
¿Es suficiente la versión Q4? Depende de la tarea. Si tienes memoria para ejecutar las dos versiones, compara la Q4 con la Q8 del mismo modelo en tres pruebas propias, como explicamos en el apartado 3.
¿Puedo usar Aya Expanse para un proyecto comercial? En principio, no. Su licencia CC-BY-NC-4.0 cubre el uso no comercial e incluye condiciones adicionales, así que consulta la ficha vigente del modelo antes de dar por hecho que puedes utilizarlo en un proyecto comercial.
¿El modelo de embeddings necesita internet tras descargarlo? No. Una vez que los pesos están en el disco, funciona sin conexión, como todos los demás modelos del kit.
Ahora te toca: instala, prueba y quédate con lo que te sirva
En la primera entrega estimaste cuánta memoria necesitaba tu portátil; en la segunda, lo preparaste. Ahora instala en él el asistente 4B y un especialista que encaje con una tarea que tengas entre manos. Ponlos a prueba con tres preguntas sobre casos propios, siguiendo las pautas del apartado 7. Quédate con el modelo que te ayude y elimina el otro con ollama rm. Plantéate comprar más memoria solo cuando una tarea real, no una ficha técnica, te demuestre que la memoria es el límite.
Aquí termina esta serie de tres entregas. Si has comprobado que tu portátil necesita más capacidad antes de seguir, la categoría de portátiles es un punto de partida razonable.

¡Suscríbete a nuestro boletín por primera vez y ahorra 15 €!
No vuelvas a perderte ninguna oferta.
Encontrarás información sobre el uso de datos personales en nuestra Política de privacidad.
Descárgate la app de refurbed
Para iOS y Android


Confirmar registro
Ya casi está: te hemos enviado un correo electrónico de confirmación
- © Refurbed Marketplace GmbH
- Accesibilidad
- Términos y Condiciones
- Política de privacidad
- Aviso legal
- Avisos legales
- European Data Act
- Cookie Policy